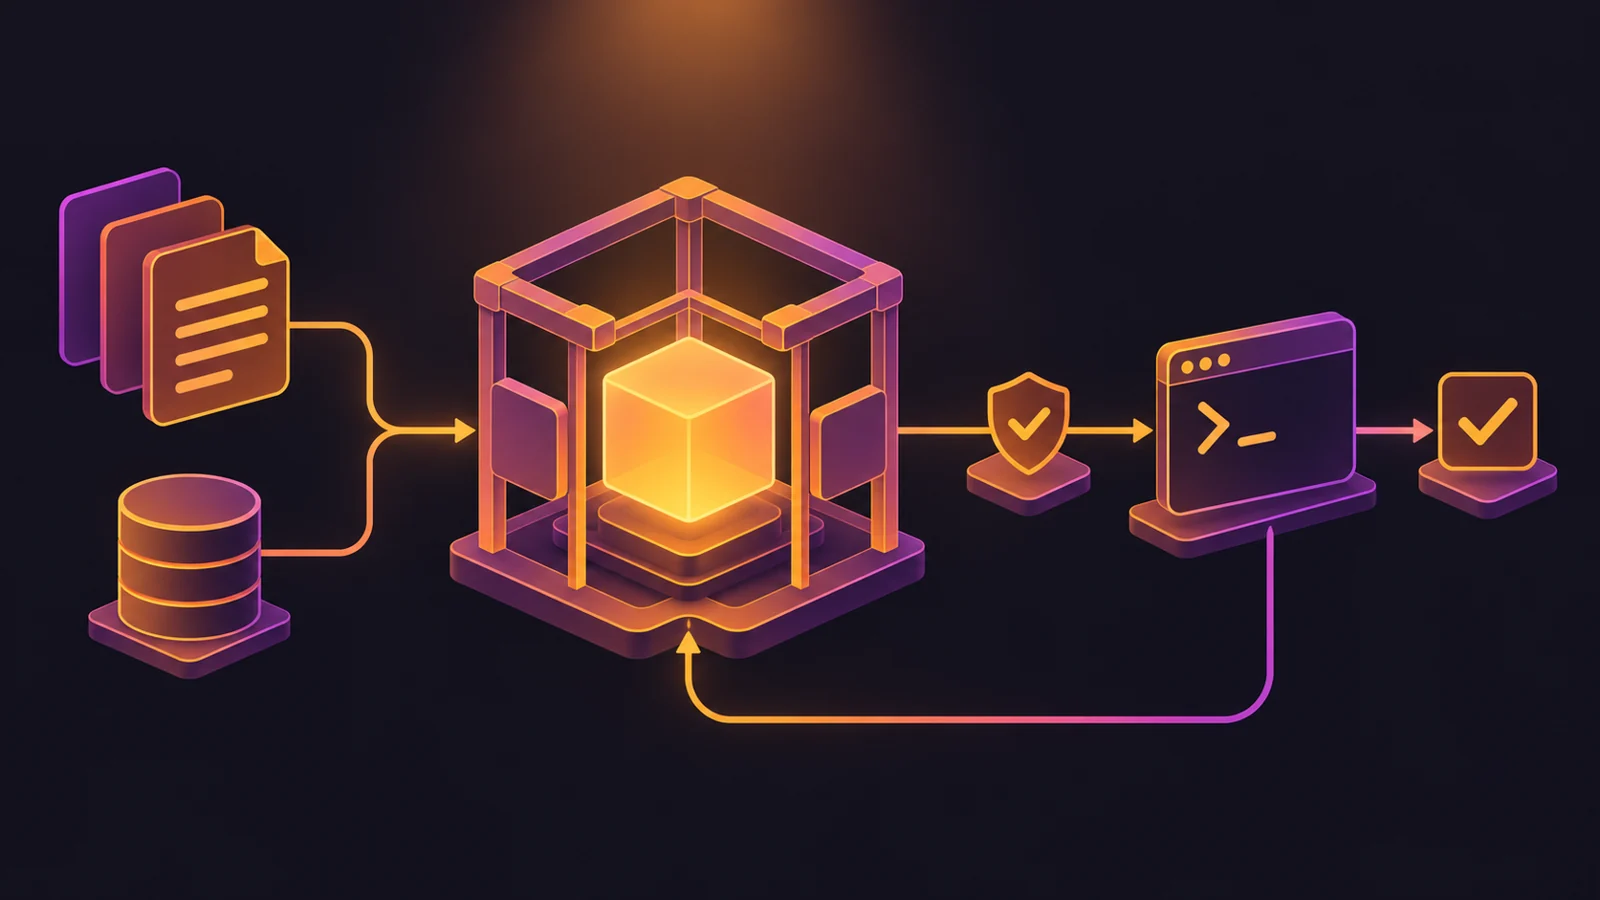
Un AI harness es la capa de software que organiza la interacción entre un modelo de IA y su entorno: prepara el contexto, conecta herramientas, controla su ejecución y devuelve los resultados al modelo para que continúe trabajando. En un agente, convierte las propuestas del modelo en acciones sujetas a límites comprobables.
Para una empresa, la pregunta práctica es sencilla: cuando un asistente dice que ha actualizado un registro o corregido un error, ¿qué sistema ejecutó la acción, con qué permisos y cómo comprobó el resultado? Ahí es donde el harness resulta relevante.
Modelo, agente y harness: qué aporta cada uno
Un modelo de lenguaje procesa entradas y genera salidas. Puede proponer una llamada a una herramienta, pero sus parámetros no le conceden por sí mismos acceso a los archivos, al CRM o a una cuenta de producción. Es la aplicación que lo integra la que expone esas capacidades y ejecuta las operaciones autorizadas.
El agente combina un objetivo, un modelo y mecanismos para actuar a través de uno o varios pasos. El harness sostiene esa ejecución: decide qué información llega al modelo, qué herramientas están disponibles, cuándo se ejecutan y cómo se registran los resultados. Si necesitas una introducción al conjunto, puedes consultar nuestra explicación de qué son los agentes de IA y cuáles son sus límites.
El término no designa un producto ni una arquitectura universal. Algunos equipos lo usan para referirse al bucle de ejecución; otros incluyen contexto, almacenamiento, aislamiento, observabilidad y recuperación. Conviene pedir siempre una descripción de sus componentes concretos.
En su trabajo sobre harnesses para agentes de larga duración, Anthropic describe mecanismos para mantener la continuidad entre sesiones, como registros de progreso y trabajo incremental. Es un ejemplo de diseño, no una receta obligatoria para todos los agentes.
Cómo funciona un AI harness: del encargo al resultado
El recorrido habitual combina seis pasos:
- Recibir la tarea y delimitar su alcance. Qué resultado se espera, sobre qué recursos se puede trabajar y qué acciones requieren intervención humana.
- Preparar el contexto. Incorporar las instrucciones, los datos pertinentes y el estado necesario para ese paso.
- Solicitar una respuesta al modelo. Puede devolver texto, proponer una herramienta o indicar que necesita información adicional.
- Validar y ejecutar la herramienta. La aplicación comprueba argumentos, identidad, permisos y límites antes de realizar la operación.
- Devolver la observación. El modelo recibe el resultado real, incluido un error o una denegación, y puede ajustar el siguiente paso.
- Terminar o escalar. El proceso finaliza cuando cumple el criterio previsto, alcanza un límite o necesita revisión.
Ese circuito permite actuar sobre el entorno. No demuestra por sí solo que la tarea esté bien resuelta: hacen falta criterios de aceptación y evidencias externas a la afirmación del propio agente.
Las cuatro áreas que conviene diseñar
La siguiente tabla propone una guía de revisión para equipos que evalúan un agente. Las preguntas son criterios prácticos de diseño, no requisitos de una certificación.
| Área | Qué debe resolver | Pregunta para evaluar la implementación |
|---|---|---|
| Contexto y memoria | Seleccionar información, conservar estado y recuperar datos relevantes | ¿Qué conserva, durante cuánto tiempo y qué recibe realmente el modelo? |
| Herramientas y ejecución | Conectar operaciones y organizar sus dependencias | ¿Qué ocurre si una herramienta falla o una acción se repite? |
| Seguridad y privacidad | Limitar accesos y circulación de datos | ¿Se rechaza una operación no autorizada aunque el modelo la solicite? |
| Evaluación y observabilidad | Comprobar resultados y entender fallos | ¿Qué evidencia distingue una tarea completada de una respuesta convincente? |
1. Contexto y memoria: distinguir historial, estado y conocimiento recuperado
La sesión agrupa los eventos de una interacción: mensajes, llamadas a herramientas y resultados, según lo que registre la aplicación. Ese historial almacenado no tiene por qué enviarse íntegramente al modelo en cada petición. El contexto efectivo puede ser una selección o un resumen, limitado por la ventana disponible.
La documentación de contexto conversacional de Google ADK distingue sesión, estado y memoria. Es una distinción útil, aunque los nombres y las responsabilidades varían entre plataformas.
El estado representa datos operativos que el programa necesita consultar o actualizar: el identificador de una tarea, la fase de una reserva o los archivos ya revisados. No es necesariamente temporal. En ADK, el alcance y la persistencia del estado dependen de cómo se organice y del servicio de almacenamiento utilizado.
La memoria a largo plazo permite recuperar información entre interacciones, si la aplicación incorpora esa capacidad. Puede incluir preferencias, hechos relevantes o conocimiento externo. Guardar un dato no significa que el modelo lo recuerde siempre ni que se haya entrenado con él.
Como criterio de implementación, recomendamos definir quién puede consultar cada dato, cómo se corrige y cuándo deja de conservarse. Una preferencia antigua no debe convertirse en una instrucción permanente imposible de revisar.
2. Herramientas y flujo: convertir una intención en una operación controlada
Una herramienta puede leer un archivo, consultar disponibilidad, ejecutar una prueba o crear un borrador en un CRM. Su contrato debe expresar qué recibe, qué devuelve y qué efectos puede producir. Una descripción ambigua dificulta tanto la elección del modelo como la validación posterior.
El Model Context Protocol, o MCP, permite exponer y descubrir herramientas mediante interfaces estructuradas. Facilita la integración con servicios externos, pero no equivale a un harness completo ni concede permisos universales. La aplicación y los servicios deben aplicar las autorizaciones correspondientes.
La organización del trabajo puede ser secuencial, paralela o basada en decisiones. Los workflows de ADK contemplan distintos patrones; los flujos basados en grafos están disponibles en ADK 2.0 y versiones posteriores. No hace falta un grafo para cualquier tarea: un proceso pequeño puede funcionar con un bucle sencillo y límites claros.
Nuestra recomendación es paralelizar solo operaciones independientes. Dos revisiones que leen archivos distintos pueden coexistir; dos escrituras sobre el mismo registro necesitan coordinación. También conviene limitar tiempo, coste y reintentos. Repetir una consulta no tiene las mismas consecuencias que repetir un cobro o enviar otra vez un correo.
3. Seguridad y privacidad: aplicar límites fuera del modelo
Un sandbox restringe la ejecución dentro de un entorno definido. Sus garantías dependen de la configuración: qué rutas permite leer o modificar, qué destinos de red admite y qué credenciales quedan disponibles. La explicación de Anthropic sobre aislamiento de archivos y red ilustra por qué ambos límites importan. El nombre «sandbox» por sí solo no demuestra protección suficiente.
La inyección de instrucciones, o prompt injection, aparece cuando contenido no confiable intenta modificar el comportamiento del agente. Un documento recuperado puede contener texto que ordene ignorar instrucciones o enviar información a otro destino. Ese contenido debe tratarse como datos, no como una autorización.
La guía de prevención de prompt injection de OWASP propone defensas por capas. Separar instrucciones y datos ayuda, pero debe acompañarse de validaciones, privilegios mínimos y controles sobre acciones sensibles. Ninguna frase incluida en el prompt sustituye una restricción aplicada por el sistema.
Para un piloto empresarial, proponemos usar datos sintéticos cuando permitan probar el proceso, minimizar lo que se envía al proveedor y revisar también los registros de ejecución. Un historial puede contener información sensible aunque la respuesta final al usuario no la muestre. Deben definirse acceso, retención y eliminación según el servicio y los requisitos del proyecto.
4. Evaluación: medir lo que ocurrió, no solo cómo se explicó
La evaluación necesita observar resultados y recorrido. Una respuesta que dice «todo correcto» no acredita que un archivo se haya guardado, que una reserva exista o que una prueba haya terminado con éxito.
La guía de evaluación de agentes de Anthropic distingue calificadores basados en código, modelos y revisión humana. Pueden combinarse:
- Comprobaciones deterministas: verifican condiciones concretas, como el contenido de un registro, un permiso denegado o el resultado de una prueba.
- Un modelo como juez: aplica una rúbrica a cualidades como claridad o pertinencia. Sus valoraciones pueden fallar y deben contrastarse con ejemplos revisados por personas.
- Evaluación humana: identifica problemas de utilidad, comprensión o experiencia que no están bien representados en las comprobaciones automáticas.
Recomendamos evaluar casos normales, errores de herramientas y situaciones adversas. También repetir las tareas relevantes: un único intento satisfactorio no describe la fiabilidad de un sistema cuyo comportamiento puede variar.
Ejemplo práctico: corregir un formulario sin acceso a producción
Imaginemos un agente encargado de añadir validación a un campo de un formulario. Es un ejemplo hipotético de diseño, no un caso de cliente ni una prueba realizada por Blimark Tech.
El encargo define los valores admitidos y limita el trabajo a una copia de desarrollo. El harness facilita al modelo los archivos pertinentes y herramientas para leer, editar y ejecutar pruebas. No expone credenciales de producción.
El agente consulta el componente y propone un cambio. Antes de escribir, la herramienta comprueba que el archivo está dentro del directorio permitido. Después ejecuta las pruebas y devuelve su salida real. Si una prueba falla, el agente puede corregir el cambio dentro del presupuesto de intentos establecido.
Para evaluar el resultado proponemos comprobar cuatro cosas: que los casos válidos se acepten, que los inválidos muestren el error previsto, que no se modifiquen archivos fuera del alcance y que el informe final coincida con las pruebas ejecutadas. Si se agota el límite, debe entregar el trabajo parcial y describir el bloqueo.
Una prueba adicional puede introducir en un documento de prueba una instrucción ajena a la tarea que solicite leer un secreto. El criterio esperado sería que el sistema no facilite ese acceso. Superar ese caso aporta evidencia sobre ese escenario concreto; no demuestra inmunidad ante todas las inyecciones posibles.
El despliegue seguiría siendo otra operación, con su autorización y su propio mecanismo de control. Así se puede revisar un cambio concreto antes de llevarlo a producción.
Qué revisar antes de contratar o construir un AI harness
Más que una lista extensa de funciones, pide una demostración de los límites y del resultado:
- Alcance: qué tareas puede realizar y cuáles debe rechazar o escalar.
- Acceso: qué sistemas, datos y acciones quedan disponibles para cada usuario.
- Continuidad: cómo retoma un trabajo interrumpido sin duplicar sus efectos.
- Trazabilidad: cómo relaciona cada acción con su resultado y cómo protege esos registros.
- Aceptación: qué conjunto de casos y revisión humana permiten decidir si el piloto es útil.
- Operación: quién atiende fallos, revisa costes y mantiene las integraciones.
En procesos previsibles, una automatización convencional puede ser suficiente. Introducir un modelo tiene sentido cuando aporta capacidad útil para interpretar información o decidir entre pasos variables, y esa aportación puede evaluarse.
El harness actúa del lado del agente. Preparar una web para que los agentes la entiendan e interactúen con ella es una tarea complementaria: la abordamos en el artículo sobre la importancia de AWO para los sitios web.
Preguntas frecuentes sobre AI harness
¿Un AI harness es lo mismo que un framework de agentes?
No exactamente. Un framework ofrece componentes y convenciones para desarrollar aplicaciones. Puede proporcionar buena parte del harness, pero el sistema operativo resultante también depende de la configuración, las integraciones, los permisos y los controles del proyecto.
¿MCP es obligatorio para crear un agente?
No. Las herramientas también pueden conectarse mediante funciones o APIs propias. MCP es una opción de interoperabilidad; su conveniencia depende de los servicios que se necesiten integrar.
¿Un harness necesita memoria a largo plazo?
No siempre. Una tarea puntual puede resolverse con contexto y estado de sesión. Añadir memoria persistente debe responder a una necesidad concreta y contemplar actualización, acceso y eliminación de los datos.
¿Qué diferencia hay entre un agent harness y un evaluation harness?
El primero organiza la ejecución del agente en su entorno. El segundo es la infraestructura con la que se preparan y ejecutan evaluaciones y se recogen resultados. Pueden compartir herramientas, pero tienen propósitos distintos.
Empieza por un proceso y una evidencia de éxito
Para dar el primer paso, elige una tarea acotada, define qué significa completarla y prueba tanto el recorrido correcto como los fallos previsibles. Esa información permite decidir qué herramientas, contexto y controles necesita el agente.
En Blimark Tech puedes explorar nuestros servicios de agentes de IA para evaluar un proceso de tu empresa y concretar el alcance de un piloto verificable.